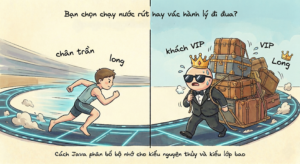
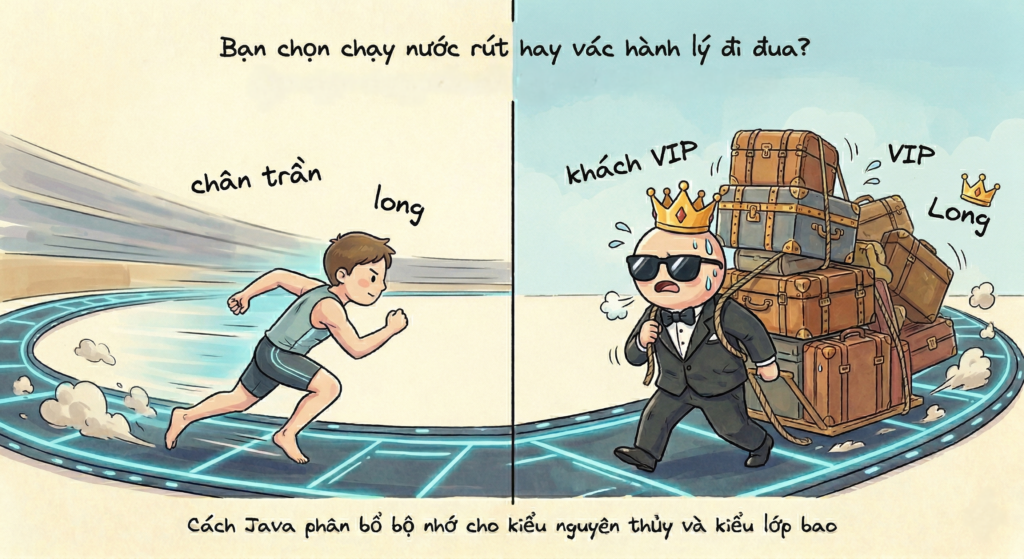
Trong lập trình Java, sự khác biệt giữa long và Long không chỉ nằm ở cú pháp mà còn ảnh hưởng trực tiếp đến hiệu năng và khả năng vận hành của hệ thống. Từ những kinh nghiệm thực tế khi đánh giá bài tập sinh viên, giảng viên FPT Polytechnic đã đưa ra góc nhìn rõ ràng về cách lựa chọn kiểu dữ liệu phù hợp để tối ưu ứng dụng.
Sự khác biệt giữa Stack và Heap
Trong Java, long là kiểu dữ liệu nguyên thủy (primitive type), được cấp phát trực tiếp trên bộ nhớ Stack, cho phép CPU truy cập nhanh chóng, tối ưu hiệu năng và không phát sinh chi phí quản lý bộ nhớ. Ngược lại, Long là một lớp bao (wrapper class) thuộc nhóm Object, được lưu trữ trên Heap. Biến Long trên Stack chỉ đóng vai trò là một tham chiếu (reference) trỏ đến đối tượng thực sự trong Heap, kéo theo chi phí bộ nhớ và thời gian xử lý lớn hơn.
Sự khác biệt này trở nên đặc biệt rõ rệt khi chương trình thực hiện các phép tính lặp lại với tần suất cao. Trong những trường hợp như vậy, việc lựa chọn không phù hợp giữa long và Long có thể dẫn đến suy giảm hiệu năng đáng kể.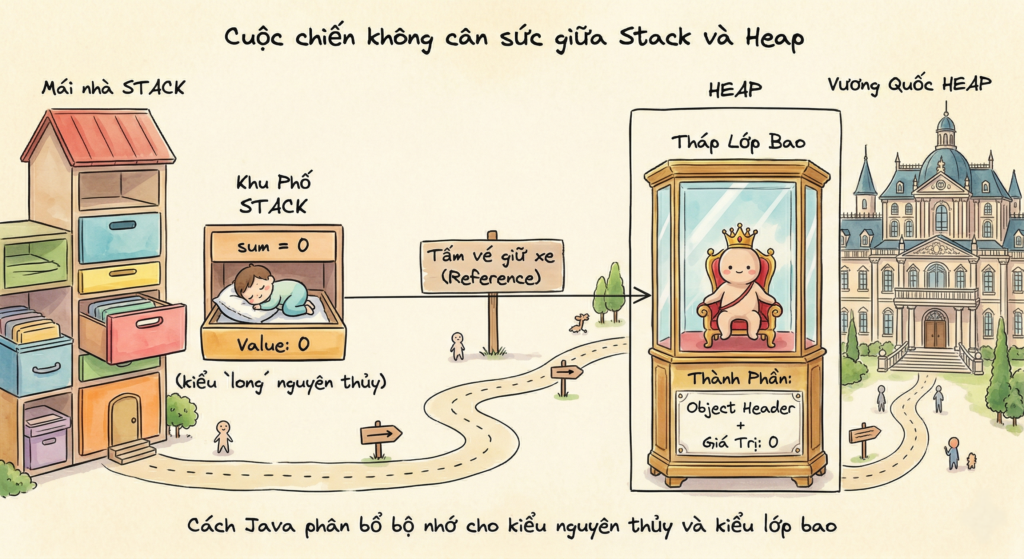
Autoboxing/Unboxing – “thủ phạm” tiêu tốn tài nguyên
Một trong những nguyên nhân chính khiến Long ảnh hưởng đến hiệu năng là cơ chế Autoboxing và Unboxing. Khi sử dụng Long trong các phép toán số học, Java phải liên tục chuyển đổi giữa kiểu nguyên thủy và đối tượng. Đặc biệt, do Long là kiểu immutable (bất biến), mỗi phép toán như sum += i sẽ tạo ra một đối tượng mới trên Heap thay vì cập nhật giá trị hiện có. Sự khác biệt trở nên rõ rệt khi chương trình thực hiện các phép tính lặp lại với tần suất cao. Xét ví dụ:
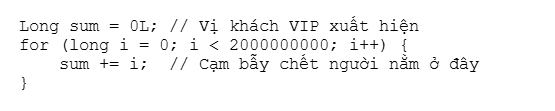
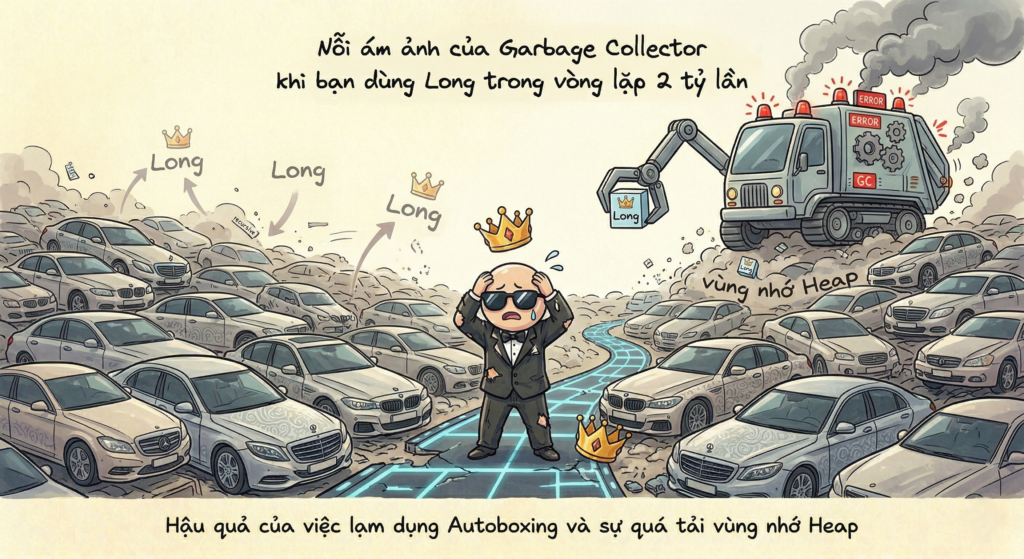
Do Long là immutable (bất biến), mỗi phép toán sum += i sẽ tạo ra một đối tượng mới thông qua cơ chế Autoboxing/Unboxing: trích xuất giá trị, thực hiện phép cộng và cấp phát một đối tượng Long mới trên Heap. Khi quá trình này lặp lại hàng tỷ lần, bộ nhớ Heap nhanh chóng bị quá tải, buộc Garbage Collector (GC) phải liên tục kích hoạt, gây ra hiện tượng “Stop-the-world”, làm gián đoạn ứng dụng và thậm chí dẫn đến lỗi OutOfMemoryError. Trong khi đó, nếu sử dụng long, phép tính chỉ diễn ra trên cùng một ô nhớ, đảm bảo tốc độ và sự ổn định của chương trình.
Ví dụ, trong một vòng lặp tính tổng từ 1 đến 2 tỷ, việc sử dụng Long đồng nghĩa với việc hệ thống phải tạo ra hàng tỷ đối tượng tạm thời. Điều này làm gia tăng áp lực lên Garbage Collector (GC), gây ra hiện tượng Stop-the-world, khiến ứng dụng bị gián đoạn hoặc thậm chí dẫn đến lỗi OutOfMemoryError. Ngược lại, khi sử dụng long, phép tính chỉ diễn ra trên cùng một ô nhớ, đảm bảo tốc độ và sự ổn định của chương trình.
Khi nào nên sử dụng Long?
Mặc dù long mang lại hiệu năng vượt trội, Long vẫn đóng vai trò quan trọng trong nhiều tình huống thực tế:
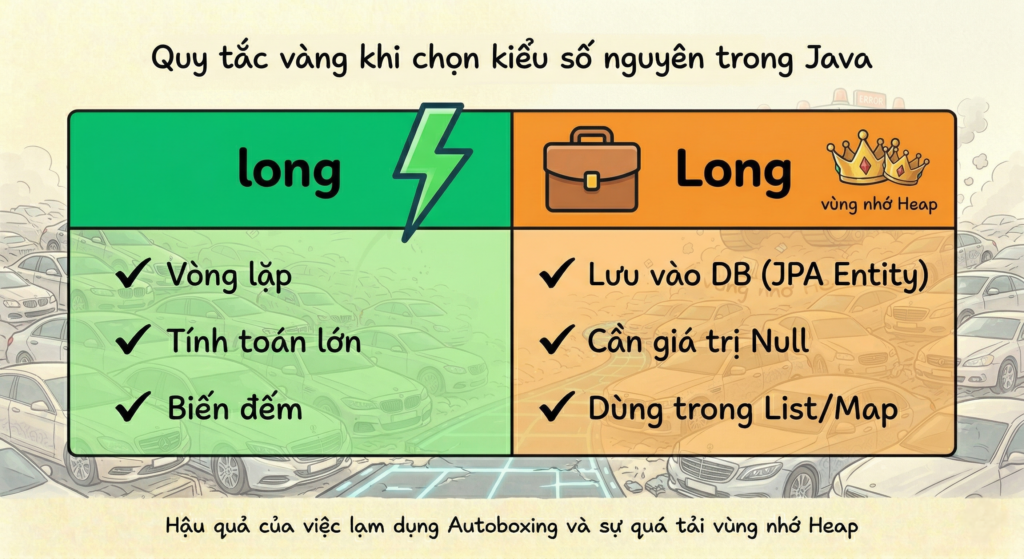
- Làm việc với Collection: Java Generic chỉ hỗ trợ kiểu Object, do đó các cấu trúc dữ liệu như ArrayList hay HashMap bắt buộc phải sử dụng Long thay vì long.
- Khả năng chứa giá trị null: long luôn có giá trị mặc định là 0, trong khi Long có thể nhận giá trị null. Điều này đặc biệt quan trọng khi làm việc với cơ sở dữ liệu thông qua các framework như Hibernate hoặc JPA, giúp phân biệt rõ ràng giữa “không có dữ liệu” và “giá trị bằng 0”.
- Tương tác với các framework: Nhiều thư viện và framework Java yêu cầu sử dụng wrapper class để đảm bảo tính linh hoạt trong xử lý dữ liệu.
Bài học về tư duy tối ưu hiệu năng
Từ góc độ đào tạo “Thực học – Thực nghiệp” của FPT Polytechnic, việc hiểu rõ bản chất của từng kiểu dữ liệu không chỉ giúp sinh viên viết chương trình chạy đúng mà còn đảm bảo hệ thống vận hành hiệu quả trong môi trường thực tế. Hiệu năng, khả năng mở rộng và mức tiêu thụ tài nguyên là những yếu tố then chốt quyết định chất lượng của một sản phẩm phần mềm. Việc lựa chọn giữa long và Long cần dựa trên mục đích sử dụng cụ thể:
- Sử dụng long khi thực hiện các phép tính số học, xử lý dữ liệu lớn hoặc các vòng lặp yêu cầu hiệu năng cao.
- Sử dụng Long khi làm việc với Collection, tương tác với cơ sở dữ liệu hoặc khi cần biểu diễn trạng thái null.
Sự khác biệt giữa long và Long là minh chứng rõ ràng cho việc những chi tiết nhỏ trong lập trình có thể tạo ra tác động lớn đến toàn bộ hệ thống. Lập trình không chỉ dừng lại ở việc “build success”, mà còn đòi hỏi sự thấu hiểu sâu sắc về cách thức vận hành của nền tảng công nghệ bên dưới.
Việc lựa chọn đúng kiểu dữ liệu không chỉ giúp tối ưu hiệu năng mà còn thể hiện tư duy chuyên nghiệp của người lập trình. Đây cũng chính là hành trang quan trọng để sinh viên FPT Polytechnic tự tin bước vào môi trường doanh nghiệp, nơi mỗi dòng code đều góp phần quyết định chất lượng và sự thành công của sản phẩm công nghệ.
Giảng viên Trần Quang Bình
Bộ môn Ứng dụng phần mềm
FPT Polytechnic TP HCM