Định luật Benford (Benford’s Law), hay còn gọi là định luật chữ số đầu tiên, mô tả quy luật phân bố xác suất của chữ số đứng đầu trong nhiều tập dữ liệu tự nhiên. Để giúp người học dễ hình dung và kiểm chứng định luật này trong thực tế, FPT Polytechnic TP HCM sẽ hướng dẫn bạn cách sử dụng Python để phân tích dữ liệu và trực quan hóa kết quả.
Ta sẽ viết code để minh họa cho định luật
Mục tiêu của đoạn code
Đoạn chương trình được xây dựng nhằm:
- Đọc dữ liệu từ file CSV (chứa các giá trị như doanh thu, dân số, số liệu thống kê…),
- Trích xuất chữ số đầu tiên của mỗi giá trị,
- So sánh phân bố thực tế với phân bố lý thuyết theo định luật Benford,
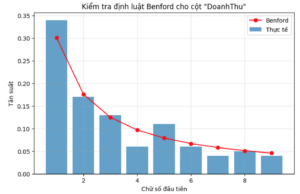
- Trực quan hóa kết quả bằng biểu đồ cột và đường để dễ quan sát.
Code mẫu Python
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
# — Hàm xử lý công thức cho định luật Benford
def benford_distribution():
“””Trả về xác suất lý thuyết của các chữ số 1-9 theo định luật Benford”””
return np.array([np.log10(1 + 1/d) for d in range(1, 10)])
# — Hàm trích chữ số đầu tiên
def get_first_digits(series):
“””Trích chữ số đầu tiên trong cột dữ liệu”””
digits = []
for value in series:
try:
s = str(value).strip().lstrip(‘-0.’)
if s and s[0].isdigit():
digits.append(int(s[0]))
except:
continue
return digits
# — Hàm kiểm tra Benford từ DataFrame mẫu—
def check_benford_df(df, column_name):
if column_name not in df.columns:
print(f“Cột ‘{column_name}‘ không tồn tại trong DataFrame.”)
print(“Các cột có sẵn:”, df.columns.tolist())
return
digits = get_first_digits(df[column_name])
if not digits:
print(“Không tìm thấy dữ liệu số hợp lệ.”)
return
# Phân bố thực tế
observed, _ = np.histogram(digits, bins=np.arange(1, 11))
observed = observed / len(digits)
# Phân bố Benford kỳ vọng
expected = benford_distribution()
# — Vẽ biểu đồ —
plt.figure(figsize=(8, 5))
plt.bar(range(1, 10), observed, alpha=0.7, label=‘Thực tế‘)
plt.plot(range(1, 10), expected, ‘ro-‘, label=‘Benford’)
plt.xlabel(‘Chữ số đầu tiên’)
plt.ylabel(‘Tần suất’)
plt.title(f‘Kiểm tra định luật Benford cho cột “{column_name}“‘)
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
# —————————————————–
# 1️ Sử dụng DataFrame mẫu trực tiếp
# —————————————————–
df_sample = pd.DataFrame({
“TenCongTy”: [“A”, “B”, “C”, “D”, “E”, “F”, “G”, “H”, “I”],
“DoanhThu”: [15432, 20149, 9812, 123000, 45821, 16789, 234501, 198765, 32190]
})
print(“=== Dữ liệu mẫu ===”)
print(df_sample)
check_benford_df(df_sample, “DoanhThu”)
# —————————————————–
# 2️.Sử dụng file CSV doanhthu.csv
# —————————————————–
# Nếu muốn dùng CSV, bỏ comment 3 dòng sau:
# csv_file = ‘doanhthu.csv’
# column_name = ‘DoanhThu’
# check_benford_df(pd.read_csv(csv_file), column_name)
Cách dùng
Chạy thử để xem một biểu đồ.
Chuẩn bị file CSV doanhthu_binhthuong.csv và doanhthu_gianlan.csv có cột chứa các số bạn muốn kiểm tra (hoặc lấy file tôi đã chuẩn bị sẵn). Sau đó sửa lệnh ở 3 dòng cuối.
Ví dụ:
| TenCongTy | DoanhThu |
| A | 15432 |
| B | 20149 |
| C | 9812 |
| D | 123000 |
Kết quả
Biểu đồ hiển thị gồm:
- Cột màu xanh: phân bố chữ số đầu tiên của dữ liệu thực tế,
- Đường màu đỏ: phân bố lý thuyết theo định luật Benford.
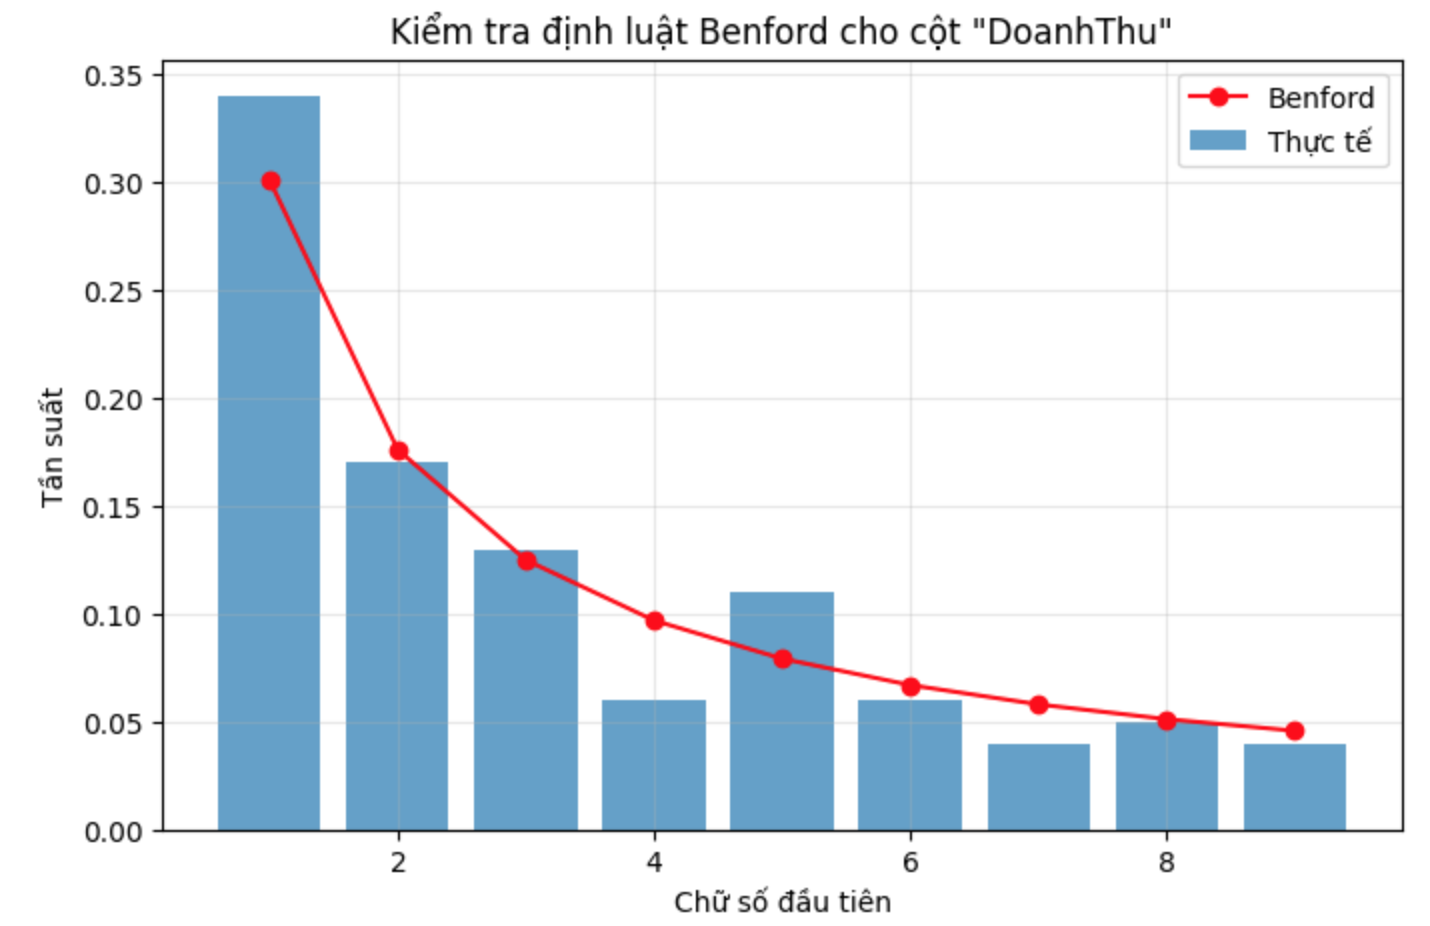
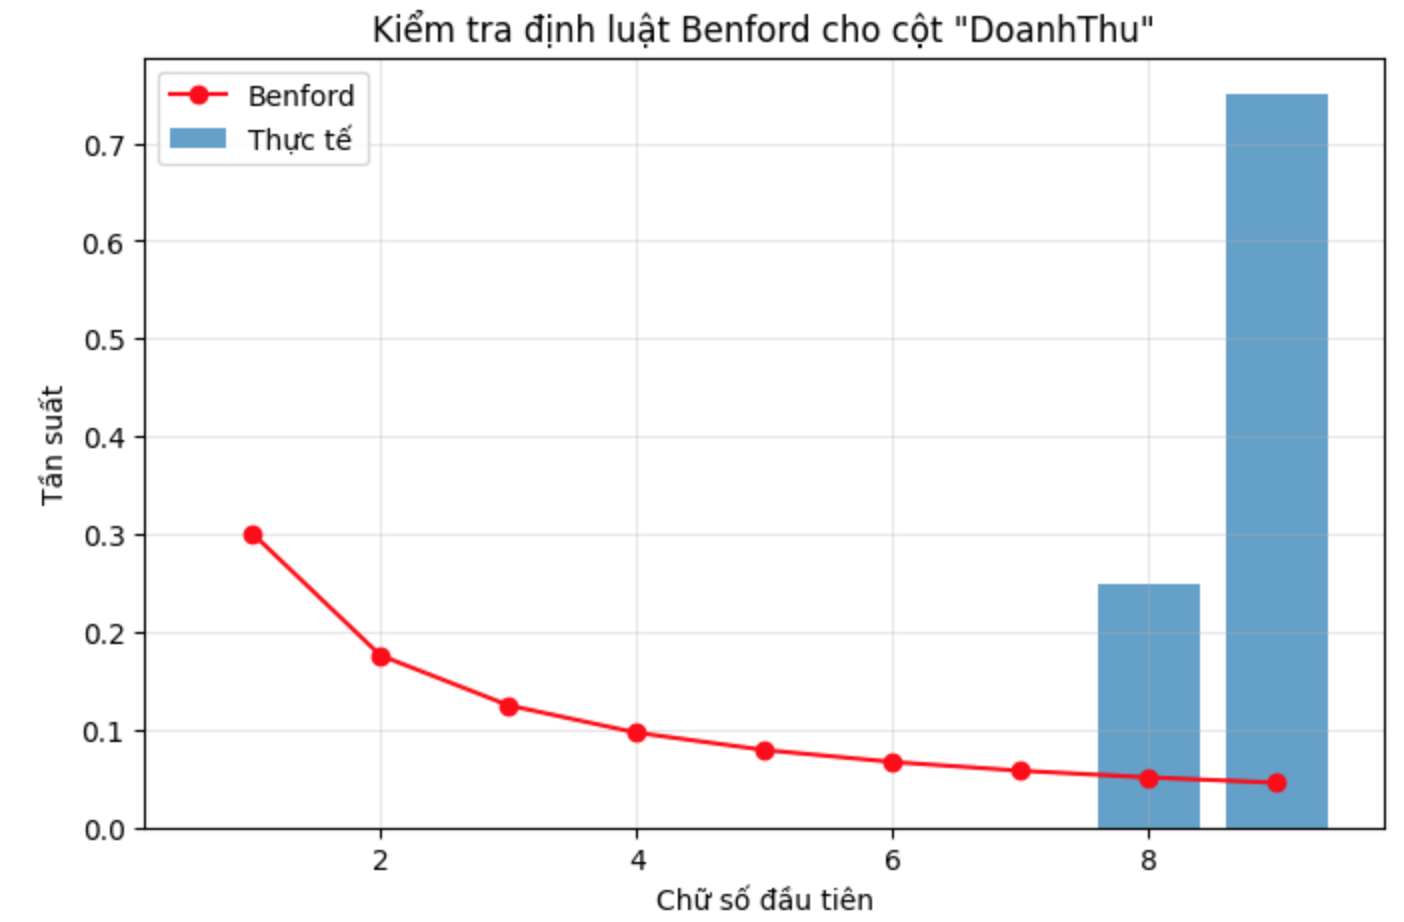
Nếu hai đường gần trùng nhau, dữ liệu có khả năng là tự nhiên và không bị can thiệp. Ngược lại, nếu có sự lệch lớn, dữ liệu có thể tồn tại bất thường, sai sót hoặc dấu hiệu bị chỉnh sửa. Trong trường hợp tập dữ liệu nhỏ, việc sai lệch so với Benford là điều bình thường và cần được cân nhắc khi phân tích.
Giảng viên Nguyễn Đỗ Anh Khoa
Bộ môn Công nghệ thông tin
FPT Polytechnic TP HCM