Nghiên cứu về tác hại của thuốc là chìa khóa để mở ra cánh cửa cho những chính sách hiệu quả. Bài viết này sẽ chia sẻ những bài học kinh nghiệm quý báu từ một dự án nghiên cứu thực tế của giảng viên Tạ Đăng Chí (Bộ môn Ứng dụng phần mềm tại FPT Polytechnic Hà Nội), nhằm góp phần vào công cuộc phòng chống tác hại của thuốc lá tại Việt Nam.
Vì sao cần nghiên cứu tác hại của thuốc lá?
Thuốc lá là một trong những nguyên nhân gây tử vong hàng đầu trên toàn thế giới, với hơn 8 triệu ca tử vong mỗi năm theo Tổ chức Y tế Thế giới (WHO). Tại Việt Nam, thuốc lá gây ảnh hưởng nghiêm trọng đến sức khỏe cộng đồng, với tỷ lệ người hút thuốc ở nam giới thuộc hàng cao nhất thế giới. Dù nhận thức về tác hại của thuốc lá đang được cải thiện, vẫn còn nhiều rào cản trong việc giảm thiểu tình trạng sử dụng thuốc lá và phơi nhiễm khói thuốc thụ động.
Việc triển khai một dự án nghiên cứu bài bản về tác hại của thuốc lá không chỉ giúp định lượng vấn đề mà còn cung cấp dữ liệu quan trọng để hỗ trợ xây dựng chính sách và chương trình phòng chống hiệu quả. Bài viết này chia sẻ kinh nghiệm thực tiễn từ quá trình triển khai dự án thu thập và phân tích dữ liệu tác hại của thuốc lá, nhằm cung cấp bài học quý giá cho các nhóm nghiên cứu và tổ chức.

Chuẩn bị dự án: Từ ý tưởng đến kế hoạch thực thi
Xác định rõ mục tiêu nghiên cứu
Bước đầu tiên và quan trọng nhất là xác định rõ ràng mục tiêu nghiên cứu. Điều này sẽ quyết định toàn bộ phương pháp, công cụ và phạm vi triển khai của dự án. Trong dự án của chúng tôi, mục tiêu bao gồm:
- Đánh giá tỷ lệ hút thuốc và mức độ phơi nhiễm khói thuốc thụ động trong cộng đồng.
- Đo lường mối liên hệ giữa hành vi hút thuốc và một số bệnh mạn tính (như ung thư phổi, bệnh tim mạch).
- Thu thập dữ liệu hỗ trợ cho các chương trình truyền thông và chính sách phòng chống thuốc lá.
- Câu hỏi nghiên cứu cần cụ thể và có thể đo lường được. Ví dụ:
- Tỷ lệ người hút thuốc tại các khu vực nông thôn và thành thị có khác biệt như thế nào?
- Khói thuốc thụ động có liên quan đến tỷ lệ mắc các bệnh đường hô hấp không?
Lập kế hoạch triển khai
Một kế hoạch triển khai chi tiết cần bao gồm:
- Phạm vi nghiên cứu: Xác định khu vực địa lý và nhóm đối tượng cụ thể. Trong dự án của chúng tôi, phạm vi bao gồm cả khu vực thành thị và nông thôn để đảm bảo tính đại diện.
- Nguồn lực: Tính toán nhân sự, thiết bị, và thời gian cần thiết cho từng giai đoạn.
- Ngân sách: Ước tính chi phí và tìm kiếm nguồn tài trợ. Chúng tôi đã hợp tác với một tổ chức y tế phi chính phủ để đảm bảo nguồn kinh phí ổn định.
- Ngoài ra, cần xây dựng một lịch trình cụ thể để theo dõi tiến độ. Mỗi giai đoạn (thu thập dữ liệu, phân tích, báo cáo) đều có thời hạn rõ ràng.
Thiết kế bộ công cụ thu thập dữ liệu
Một bộ công cụ hiệu quả là yếu tố then chốt quyết định chất lượng của dữ liệu. Dữ liệu được thu thập thực mọi nhóm người, mọi lứa tuổi, thể trạng, tình trạng bệnh ký, giới tính…
Bảng hỏi: Cấu trúc bảng hỏi gồm các phần chính như:
- Thông tin nhân khẩu học (tuổi, giới tính, nghề nghiệp).
- Hành vi hút thuốc (loại thuốc lá, tần suất, thời gian bắt đầu hút).
- Phơi nhiễm khói thuốc (tại nhà, nơi làm việc).
- Tình trạng sức khỏe (bệnh mạn tính, triệu chứng hô hấp).
Công cụ số hóa: Ứng dụng các nền tảng như KoboToolbox hoặc Google Forms để thu thập dữ liệu điện tử. Điều này giúp giảm thiểu sai sót khi nhập liệu và tăng tính bảo mật.
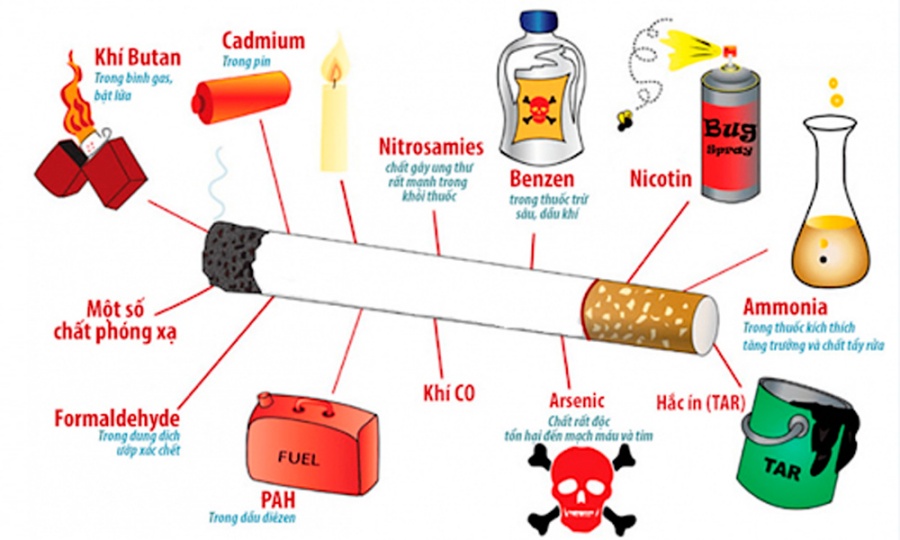
Triển khai thu thập dữ liệu thực địa tại
Đào tạo nhân sự
Đội ngũ thu thập dữ liệu cần được đào tạo bài bản để đảm bảo sự nhất quán và độ chính xác. Các buổi thảo luận, tập huấn tập trung vào:
- Kỹ năng phỏng vấn, cách đặt câu hỏi một cách trung lập và không dẫn dắt.
- Quy trình xử lý các tình huống nhạy cảm, như khi người tham gia không thoải mái trả lời.
- Sử dụng phần mềm thu thập dữ liệu và ghi chép thông tin.
Triển khai khảo sát tại hiện trường
Chúng tôi đã áp dụng phương pháp kết hợp:
- Khảo sát trực tuyến: Triển khai tại các khu vực thành phố lớn, nơi người dân dễ tiếp cận với thiết bị công nghệ.
- Khảo sát trực tiếp: Tiến hành tại các vùng nông thôn, nơi điều kiện tiếp cận internet còn hạn chế.
Ở một số khu vực, người dân e ngại việc tham gia do lo ngại thông tin cá nhân bị tiết lộ. Chúng tôi đã khắc phục bằng cách giải thích rõ ràng về tính bảo mật và cung cấp tài liệu minh bạch. Bên cạnh đó, chúng tôi hợp tác với chính quyền địa phương giúp tăng cường lòng tin của cộng đồng và đảm bảo tỷ lệ phản hồi cao.
Xử lý và phân tích dữ liệu
Làm sạch dữ liệu
Trước khi phân tích, dữ liệu cần được kiểm tra và làm sạch:
- Loại bỏ các bản khảo sát không hợp lệ (như trả lời không đầy đủ hoặc không trung thực).
- Chuẩn hóa dữ liệu để dễ phân tích. Ví dụ: Mã hóa các biến định tính như giới tính (0 = nam, 1 = nữ).
- Chúng ta có thể sử dung các công cụ khác nhau nhưng trong bài viết này tôi giới thiệu Python với công cụ Pandas, Numpy, chúng ta cùng tìm hiểu và so sánh.
Pandas
Sử dụng Pandas để xử lý và thao tác với dữ liệu dạng bảng (DataFrame).
Các thao tác phổ biến:
import pandas as pd
# Đọc dữ liệu từ file CSV
df = pd.read_csv(“survey_data.csv”)
# Xử lý giá trị thiếu
df.fillna(method=’ffill’, inplace=True)
# Mã hóa dữ liệu (ví dụ: 0 = không hút thuốc, 1 = hút thuốc)
df[‘smoking_status’] = df[‘smoking_status’].map({‘No’: 0, ‘Yes’: 1})
# Xem thống kê cơ bản
print(df.describe())
NumPy
NumPy cung cấp khả năng tính toán số học nhanh và xử lý dữ liệu số lớn.
Ví dụ:
import numpy as np
# Tính trung bình và độ lệch chuẩn của tuổi người hút thuốc
mean_age = np.mean(df[‘age’])
std_age = np.std(df[‘age’])
print(f”Mean Age: {mean_age}, Std Dev: {std_age}”)
Phân tích thống kê
Phân tích dữ liệu bao gồm các bước sau:
- Phân tích mô tả: Đánh giá tỷ lệ người hút thuốc, mức độ phơi nhiễm khói thuốc và các đặc điểm nhân khẩu học.
- Phân tích mối quan hệ:
- Kiểm định Chi-square để phân tích sự khác biệt về hành vi hút thuốc giữa các nhóm.
- Hồi quy logistic để xác định yếu tố nguy cơ (ví dụ: nguy cơ mắc bệnh hô hấp ở người hút thuốc).
Ví dụ kết quả:
- Tỷ lệ người hút thuốc: 25% (nam giới: 40%, nữ giới: 10%).
- Phơi nhiễm khói thuốc thụ động: 60% người tham gia báo cáo thường xuyên tiếp xúc với khói thuốc tại nhà hoặc nơi làm việc.
Phân tích dữ liệu mô tả
Matplotlib và Seaborn:
- Matplotlib: Tạo biểu đồ cơ bản như biểu đồ cột, biểu đồ tán xạ.
- Seaborn: Cung cấp các biểu đồ chuyên biệt với giao diện trực quan.
Ví dụ vẽ biểu đồ:
import matplotlib.pyplot as plt
import seaborn as sns
# Vẽ biểu đồ phân phối tuổi người hút thuốc
sns.histplot(df[‘age’], bins=20, kde=True)
plt.title(‘Phân phối tuổi của người hút thuốc’)
plt.xlabel(‘Tuổi’)
plt.ylabel(‘Tần suất’)
plt.show()
# Vẽ biểu đồ tần suất theo giới tính và hành vi hút thuốc
sns.countplot(data=df, x=’gender’, hue=’smoking_status’)
plt.title(‘Tần suất hút thuốc theo giới tính’)
plt.xlabel(‘Giới tính’)
plt.ylabel(‘Tần suất’)
plt.show()
Phân tích mối quan hệ và kiểm định thống kê
a) Kiểm định Chi – Square:
Phân tích mối quan hệ giữa các biến định tính (ví dụ: giới tính và hành vi hút thuốc).
from scipy.stats import chi2_contingency
# Tạo bảng tần suất giữa giới tính và hành vi hút thuốc
contingency_table = pd.crosstab(df[‘gender’], df[‘smoking_status’])
# Kiểm định Chi-square
chi2, p, dof, expected = chi2_contingency(contingency_table)
print(f”Chi2: {chi2}, p-value: {p}”)
b) T – test (so sánh trung bình giữa 2 nhóm)
Ví dụ: So sánh tuổi trung bình giữa nhóm hút thuốc và không hút thuốc.
from scipy.stats import ttest_ind
# Tách 2 nhóm
smokers = df[df[‘smoking_status’] == 1][‘age’]
non_smokers = df[df[‘smoking_status’] == 0][‘age’]
# Thực hiện kiểm định T-test
t_stat, p_value = ttest_ind(smokers, non_smokers)
print(f”T-statistic: {t_stat}, p-value: {p_value}”)
c) ANOVA (so sánh trung bình của nhiều nhóm)
Ví dụ: So sánh mức độ phơi nhiễm khói thuốc giữa nhiều khu vực.
from scipy.stats import f_oneway
# So sánh mức độ phơi nhiễm khói thuốc giữa 3 khu vực
urban = df[df[‘region’] == ‘Urban’][‘exposure’]
rural = df[df[‘region’] == ‘Rural’][‘exposure’]
industrial = df[df[‘region’] == ‘Industrial’][‘exposure’]
f_stat, p_value = f_oneway(urban, rural, industrial)
print(f”F-statistic: {f_stat}, p-value: {p_value}”)
Phân tích và dự đoán bằng thuật toán hồi quy
a) Hồi quy tuyến tính:
Ví dụ: Dự đoán mức phơi nhiễm khói thuốc (biến liên tục) dựa trên số lượng người hút thuốc trong gia đình.
from sklearn.linear_model import LinearRegression
# Chuẩn bị dữ liệu
X = df[[‘number_of_smokers_in_household’]] # Biến độc lập
y = df[‘exposure’] # Biến phụ thuộc
# Xây dựng mô hình
model = LinearRegression()
model.fit(X, y)
# Hệ số hồi quy
print(f”Intercept: {model.intercept_}, Coefficients: {model.coef_}”)
b) Hồi quy logistic:
Ví dụ: Dự đoán khả năng mắc bệnh COPD dựa trên hành vi hút thuốc và phơi nhiễm.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix
# Chuẩn bị dữ liệu
X = df[[‘smoking_status’, ‘exposure’]] # Biến độc lập
y = df[‘has_COPD’] # Biến phụ thuộc (0 hoặc 1)
# Chia dữ liệu thành tập huấn luyện và kiểm tra
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Xây dựng mô hình hồi quy logistic
model = LogisticRegression()
model.fit(X_train, y_train)
# Đánh giá mô hình
y_pred = model.predict(X_test)
print(classification_report(y_test, y_pred))
print(confusion_matrix(y_test, y_pred))
Trực quan hóa mối quan hệ phức tạp
Sử dụng các thư viện nâng cao như Plotly hoặc Altair để vẽ biểu đồ tương tác, giúp người xem dễ hiểu hơn về dữ liệu.
Ví dụ: Vẽ biểu đồ tán xạ với đường hồi quy.
import plotly.express as px
# Vẽ biểu đồ tán xạ giữa phơi nhiễm và nguy cơ mắc bệnh
fig = px.scatter(df, x=’exposure’, y=’has_COPD’, trendline=’ols’)
fig.show()
Clustering (Phân nhóm dữ liệu)
Sử dụng thuật toán K – means để phân nhóm các đối tượng dựa trên đặc điểm (ví dụ: mức độ hút thuốc và phơi nhiễm).
from sklearn.cluster import KMeans
# Chuẩn bị dữ liệu
X = df[[‘smoking_status’, ‘exposure’]]
# Áp dụng K-means
kmeans = KMeans(n_clusters=3, random_state=42)
df[‘cluster’] = kmeans.fit_predict(X)
# Trực quan hóa kết quả phân cụm
sns.scatterplot(data=df,x=’smoking_status’,y=’exposure’,hue=’cluster’,palette=’viridis’)
plt.title(‘Phân nhóm đối tượng dựa trên hành vi hút thuốc và phơi nhiễm’)
plt.show()
Kết quả và ứng dụng
Các phát hiện quan trọng:
- Hành vi hút thuốc: Hơn 30% người hút thuốc bắt đầu từ tuổi vị thành niên, cho thấy cần có biện pháp giáo dục từ sớm.
- Khói thuốc thụ động: Phụ nữ và trẻ em là nhóm chịu ảnh hưởng nhiều nhất, đặc biệt tại các khu vực nông thôn.
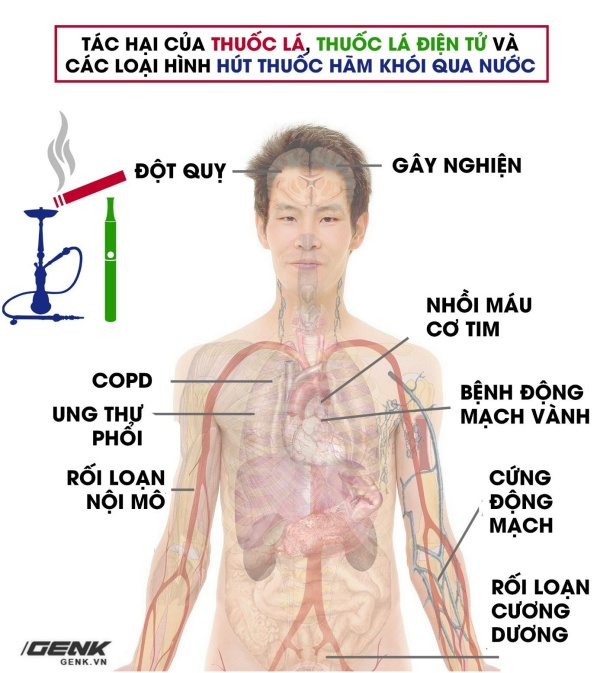
- Bệnh lý liên quan: Tỷ lệ mắc bệnh COPD ở người hút thuốc cao hơn 3 lần so với người không hút thuốc.
Ứng dụng dữ liệu vào thực tiễn:
- Xây dựng chính sách: Dữ liệu được cung cấp cho các cơ quan y tế để thiết lập vùng cấm hút thuốc tại nơi công cộng và trường học.
- Nâng cao nhận thức: Phát triển các tài liệu truyền thông nhấn mạnh tác hại của khói thuốc thụ động đối với trẻ em.
Giảng viên Tạ Đăng Chí
Bộ môn Ứng dụng phần mềm
FPT Polytechnic Hà Nội