Trong thời đại dữ liệu phát triển mạnh mẽ, việc xử lý và phân tích dữ liệu bằng Python đã trở thành kỹ năng quan trọng đối với sinh viên chuyên ngành Xử lý dữ liệu. Trong đó, thư viện Pandas được xem là “vũ khí quốc dân” dành cho Data Analyst, Data Scientist và AI Engineer nhờ khả năng thao tác dữ liệu nhanh, trực quan và mạnh mẽ.
Tuy nhiên, khi dữ liệu ngày càng lớn, nhiều sinh viên thường gặp các vấn đề như:
- Code xử lý chậm
- Tốn nhiều RAM
- GroupBy hoặc Merge mất nhiều thời gian
- Dashboard trực quan phản hồi chậm
Dựa trên tổng hợp các bài viết và thực hành phân tích chuyên sâu, bài viết này sẽ tổng hợp các mẹo (tips) quan trọng giúp sinh viên tối ưu quá trình phân tích dữ liệu với Pandas và làm quen với xu hướng mới là thư viện Polars.
Vì sao Pandas vẫn là thư viện “quốc dân”?
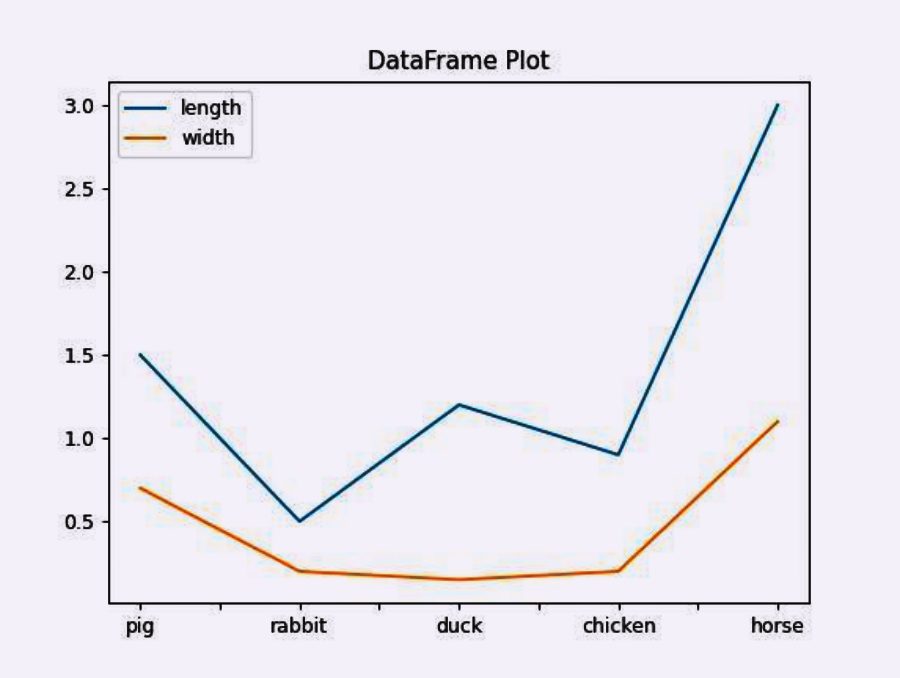
Pandas được sử dụng rộng rãi trong:
- Phân tích dữ liệu
- Machine Learning
- Business Intelligence
- Data Visualization
- AI và Deep Learning
Ưu điểm lớn nhất của Pandas:
- Cú pháp dễ học
- Hỗ trợ DataFrame trực quan
- Tích hợp tốt với NumPy, Matplotlib, Scikit-learn
- Có cộng đồng cực lớn
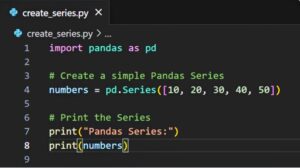
Ví dụ đọc file CSV đơn giản:
import pandas as pd
df = pd.read_csv(“sales_data.csv”)
print(df.head())
Chỉ với vài dòng code, sinh viên đã có thể đọc và xử lý dữ liệu thực tế.
Tip 1: Tối ưu GroupBy để xử lý dữ liệu nhanh hơn
Một trong những thao tác phổ biến nhất của sinh viên là thống kê dữ liệu theo nhóm.
Ví dụ:
- Tổng doanh thu theo tháng
- Tổng số sinh viên theo lớp
- Thống kê số lượng đơn hàng
Ví dụ Pandas
import pandas as pd
df = pd.read_csv(“sales.csv”)
result = df.groupby(“month”)[“revenue”].sum()
print(result)
Tip 2: Hạn chế dùng vòng lặp for trong Pandas
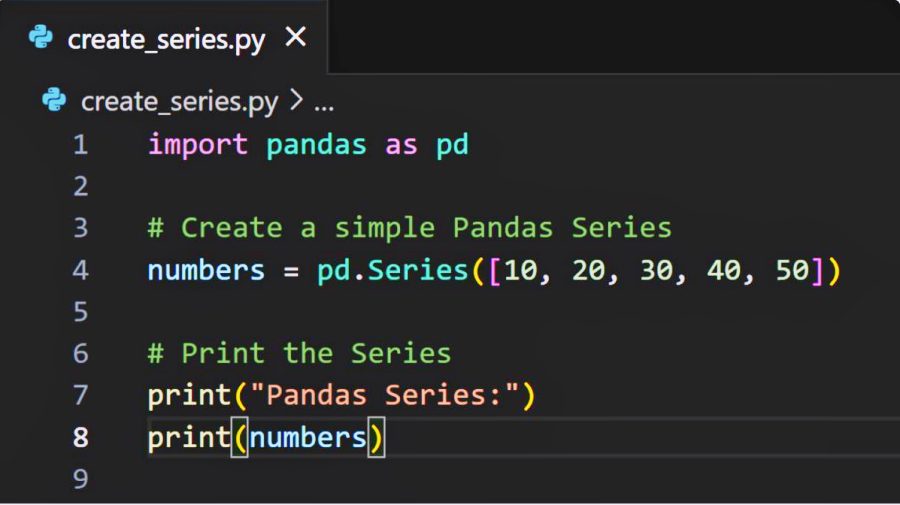
Nhiều sinh viên mới học thường xử lý dữ liệu bằng vòng lặp:
for i in range(len(df)):
df.loc[i, “profit”] = df.loc[i, “revenue”] – df.loc[i, “cost”]
Cách này hoạt động nhưng rất chậm.
Cách tối ưu hơn:
df[“profit”] = df[“revenue”] – df[“cost”]
Đây gọi là vectorized operations — thao tác trên toàn bộ cột dữ liệu cùng lúc.
Ưu điểm:
- Tốc độ nhanh hơn nhiều
- Code ngắn gọn
- Ít lỗi hơn
Tip 3: Sử dụng Merge thay cho xử lý thủ công
Khi làm project lớn, sinh viên thường phải kết hợp nhiều bảng dữ liệu.
Ví dụ:
- Bảng sinh viên
- Bảng điểm
- Bảng lớp học
Ví dụ Merge
students = pd.read_csv(“students.csv”)
scores = pd.read_csv(“scores.csv”)
result = pd.merge(students, scores, on=”student_id”)
print(result.head())
Pandas hỗ trợ:
- inner join
- left join
- right join
- outer join
Tương tự SQL.
Tip 4: Trực quan hóa dữ liệu bằng Pandas + Matplotlib
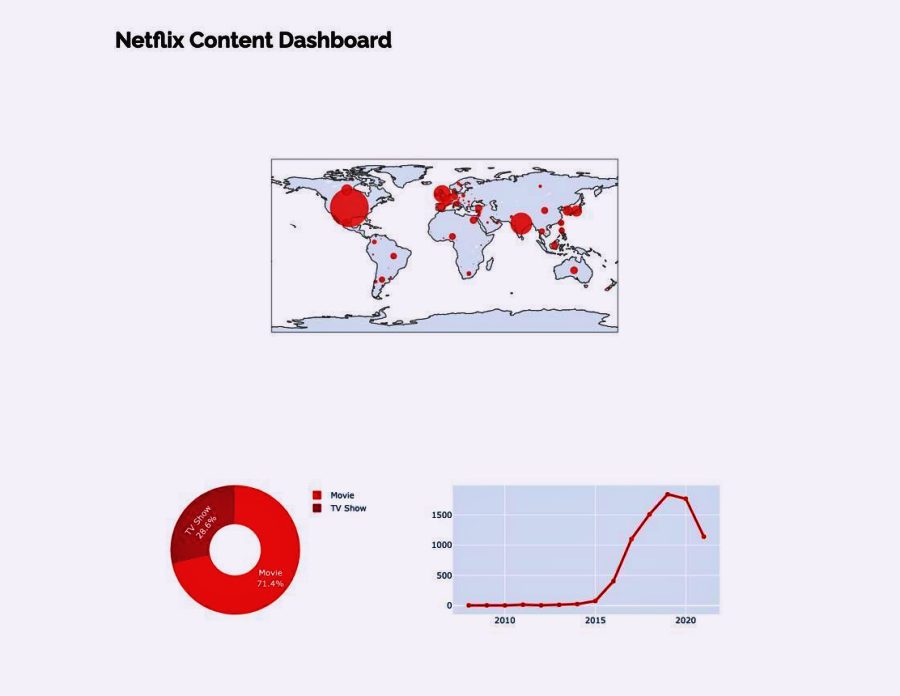
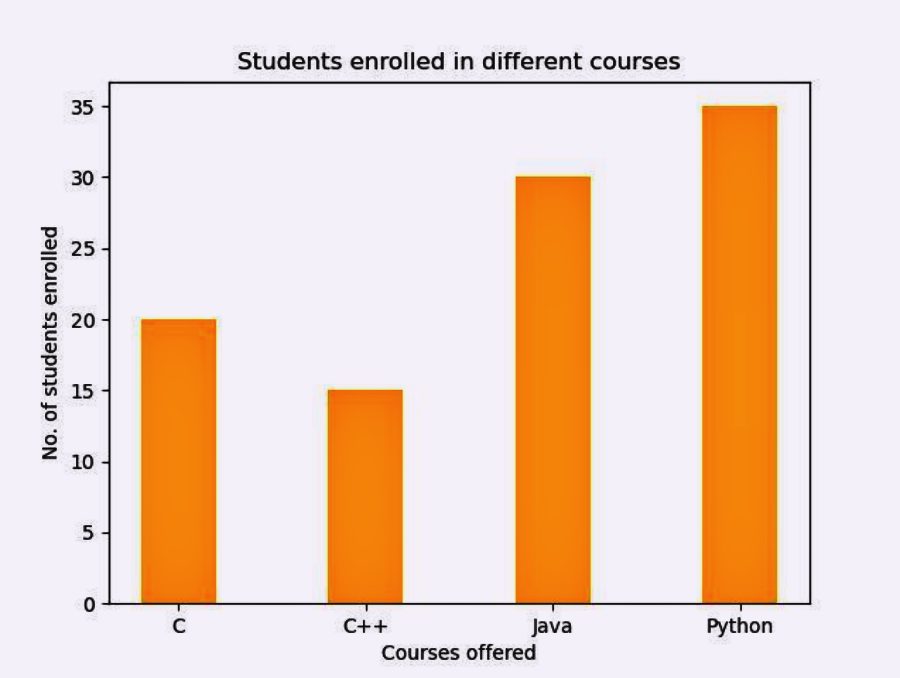
Một kỹ năng quan trọng của sinh viên ngành Xử Lý Dữ Liệu là trình bày dữ liệu trực quan.
Ví dụ biểu đồ doanh thu:
import matplotlib.pyplot as plt
df.groupby(“month”)[“revenue”].sum().plot(kind=”bar”)
plt.title(“Doanh thu theo tháng”)
plt.show()
Các dạng biểu đồ phổ biến:
- Bar chart
- Pie chart
- Line chart
- Heatmap
- Radar chart
Trong các buổi học thực tế, sinh viên thường xây dựng dashboard mini bằng:
- Pandas
- Matplotlib
- Plotly
- Streamlit
Tip 5: Khi nào nên dùng Polars thay cho Pandas?
Pandas hoạt động tốt với dữ liệu vừa và nhỏ. Tuy nhiên khi dữ liệu lên đến hàng triệu dòng, tốc độ có thể giảm đáng kể. Polars có thể nhanh hơn từ 5–10 lần trong các tác vụ GroupBy lớn nhờ cơ chế xử lý song song đa luồng. Polars đang trở thành xu hướng mới trong xử lý dữ liệu Python nhờ:
- Viết bằng Rust
- Tự động dùng đa luồng CPU
- Lazy execution
- Tối ưu RAM tốt hơn Pandas
Ví dụ Polars
import polars as pl
df = pl.read_csv(“sales.csv”)
result = (
df.group_by(“month”)
.agg(pl.col(“revenue”).sum())
)
print(result)
Theo benchmark thực tế:
- GroupBy nhanh hơn đến 8x
- Aggregation nhanh hơn hơn 20x
- Filtering nhanh hơn khoảng 4x
Tuy nhiên:
- Pandas vẫn phù hợp cho người mới học
- Hệ sinh thái Pandas hiện tại vẫn phổ biến hơn
- Polars phù hợp cho dữ liệu lớn hoặc ETL production
Xu hướng mới cho sinh viên chuyên ngành Xử lý dữ liệu
Hiện nay, nhiều doanh nghiệp yêu cầu sinh viên:
- Thành thạo Pandas
- Biết trực quan hóa dữ liệu
- Hiểu ETL pipeline
- Tối ưu hiệu suất xử lý dữ liệu
Do đó, ngoài việc học Pandas cơ bản, sinh viên nên:
- Làm project thực tế
- Thực hành dashboard
- Tìm hiểu Polars
- Học thêm SQL và Machine Learning
Pandas vẫn là thư viện quan trọng nhất đối với sinh viên ngành Xử Lý Dữ Liệu. Tuy nhiên, việc hiểu cách tối ưu code và làm quen với các công nghệ mới như Polars sẽ giúp sinh viên nâng cao hiệu suất xử lý dữ liệu và đáp ứng tốt hơn nhu cầu doanh nghiệp hiện đại.
Thông qua các project trực quan dữ liệu bằng Python, sinh viên không chỉ học cách viết code mà còn rèn luyện:
- Tư duy phân tích dữ liệu
- Data storytelling
- Tối ưu hiệu năng
- Kỹ năng teamwork và báo cáo
Đây chính là nền tảng quan trọng để sinh viên tự tin bước vào lĩnh vực Data Analytics, AI và Data Science trong tương lai.
Giảng viên Nguyễn Phạm Khánh Ngọc
Bộ môn Ứng dụng phần mềm
FPT Polytechnic TP HCM