Trong thời đại số hóa ngày nay, dữ liệu trở thành một tài nguyên quý giá. Nhưng không phải tất cả thông tin đều sẵn sàng để được sử dụng. Đây là nơi mà “web scraping” (kỹ thuật trích xuất dữ liệu từ trang web) trở nên quan trọng. Với sự giúp đỡ của các công cụ như Puppeteer, người dùng có thể khám phá và thu thập dữ liệu từ trang web một cách hiệu quả và tự động.
Trong bài viết này, hãy cùng tìm hiểu về Web Scraping và cách sử dụng Puppeteer để thực hiện nhiệm vụ này.
Web Scraping: Trích xuất dữ liệu trực tuyến
Web scraping là quá trình tự động trích xuất dữ liệu từ trang web. Điều này cho phép bạn thu thập thông tin một cách tự động và hiệu quả từ hàng loạt trang web, mà không cần phải duyệt qua từng trang một.
Với Web Scraping, người dùng có thể
- Nghiên cứu thị trường: Hiểu rõ về xu hướng và ý kiến của khách hàng.
- Giám sát giá cả: Theo dõi giá cả sản phẩm và dịch vụ của đối thủ cạnh tranh.
- Tổ chức dữ liệu: Tập hợp dữ liệu từ nhiều nguồn để phân tích và sử dụng.
Puppeteer: Sức mạnh của trình duyệt trong tầm tay
Puppeteer là một thư viện Node.js được phát triển bởi Chrome DevTools Team. Nó cung cấp một giao diện điều khiển trình duyệt Chrome hoàn toàn có thể tương tác, cho phép người dùng thực hiện các tác vụ như mở trang web, điều hướng, thậm chí là điền form và chụp ảnh màn hình.
- Cài đặt Puppeteer: Trước tiên, người dùng cài đặt Puppeteer trong project Node.js của mình bằng lệnh sau:
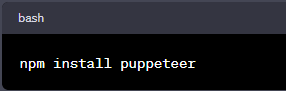
2. Ví dụ về trích xuất tiêu đề trang web
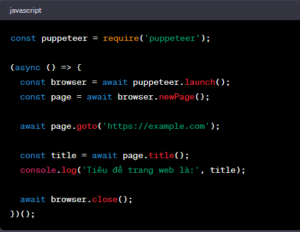
Dưới đây là một ví dụ đơn giản về việc sử dụng Puppeteer để trích xuất tiêu đề của một trang web:
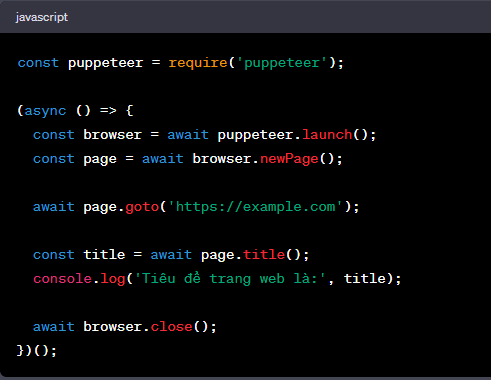
Trong đoạn mã trên, chúng ta mở trình duyệt, điều hướng đến trang web mẫu (‘https://example.com‘), sau đó trích xuất tiêu đề của trang và in ra console.
3. Chế độ Headless và Non-Headless
Headless là chế độ giúp bạn có thể thực hiện các chương trình điều khiển browser mà không cần hiện browser lên màn hình, các browser sẽ được chạy ngầm trong hệ thống. Puppeteer chạy với chệ độ mặc định là Headless (Chạy ngầm) . Chế độ này giúp máy tính tiết kiệm tài nguyên để render hình ảnh cho các browser.
- Các tính năng mạnh mẽ khác của Puppeteer:
- Trích xuất dữ liệu: Puppeteer cho phép bạn trích xuất văn bản, hình ảnh, và các loại dữ liệu khác từ trang web.
- Chụp ảnh màn hình: Bạn có thể chụp ảnh màn hình của trang web hoặc phần cụ thể của trang.
- Tương tác người dùng: Puppeteer cho phép bạn điều hướng, điền biểu mẫu, và thậm chí là chạy các đoạn mã JavaScript trên trang web.
Những thách thức và lưu ý trong Web Scraping
Mặc dù web scraping mang lại nhiều lợi ích, nhưng cũng có những thách thức và rủi ro:
- Pháp lý: Trước khi thực hiện web scraping, hãy kiểm tra quy định và điều khoản sử dụng của trang web đó. Một số trang web có chính sách cấm web scraping.
- Bị chặn IP: Nhiều trang web sử dụng các biện pháp để ngăn chặn web scraping bằng cách chặn các địa chỉ IP của các máy chủ scrapers.
- Dữ liệu thay đổi: Cấu trúc và định dạng của trang web có thể thay đổi, làm hỏng các kịch bản web scraping.
Web scraping là một công cụ mạnh mẽ cho việc thu thập dữ liệu trực tuyến. Với sự giúp đỡ của Puppeteer, chúng ta có thể tự động hóa quá trình này một cách dễ dàng. Tuy nhiên, việc sử dụng web scraping cần phải được thực hiện cẩn thận và có ý thức về quy định và luật lệ để tránh gây ra các vấn đề pháp lý. Sử dụng đúng cách, web scraping có thể là công cụ hữu ích giúp chúng ta đào tạo dữ liệu và hiểu rõ hơn về thế giới trực tuyến xung quanh chúng ta.
Giảng viên Nguyễn Quang Hà
Bộ môn Ứng dụng phần mềm
Trường Cao đẳng FPT Polytechnic cơ sở Hà Nội