Dữ liệu là một trong những yếu tố quan trọng quyết định chất lượng của quá trình huấn luyện, cũng như tạo ra các model của các chương trình AI. Thông thường sẽ có 2 bước cần phải làm với dữ liệu: Thu thập và xử lý dữ liệu. Dữ liệu sau khi thu thập có thể bị thiếu, dư thừa, không chính xác.. thông tin, cần phải có bước xử lý trước khi đưa vào mô hình. Ở bài viết này, chúng ta sẽ tìm hiểu một vài bước phổ biến ở xử lý dữ liệu sau khi đã được thu thập.
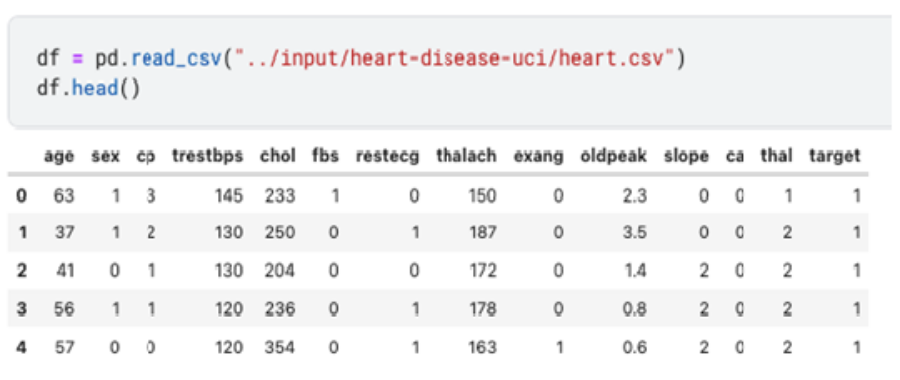
Các chương trình AI thiên về phân loại, dự đoán thì data đưa vào thường sẽ lưu trữ dạng bảng trong file csv ví dụ: train.csv, test.csv. Chúng ta sẽ lưu các đặc tính (feature) của dataset vào trong các cột ở bảng file csv. Ví dụ: Muốn dự đoán giá của một căn nhà, chúng ta phải có ít nhất các feature cơ bản như sau: cột diện tích, số lượng phòng, vị trí, số tầng, độ tuổi căn nhà… Tất cả các yếu tố có thể ảnh hưởng tới kết quả chương trình mà có thể được biểu diễn bằng con số, hoặc vài trạng thái cụ thể. Số lượng các cột feature sẽ không quá nhiều, tầm dưới 10 cột sẽ tốt hơn cho các chương trình AI nhỏ. Trong quá trình trainning, các thuật toán, neuron sẽ học từ các feature này để tạo ra model.
Các bước cơ bản ban đầu để làm sạch dữ liệu:
- Eliminate duplicate (loại bỏ các dữ liệu trùng lặp), normalizing (nhất quán dữ liệu)… Chúng ta có thể sử dụng Pandas library… để hiện ra những mẫu thiếu thông tin, mẫu bị trùng…
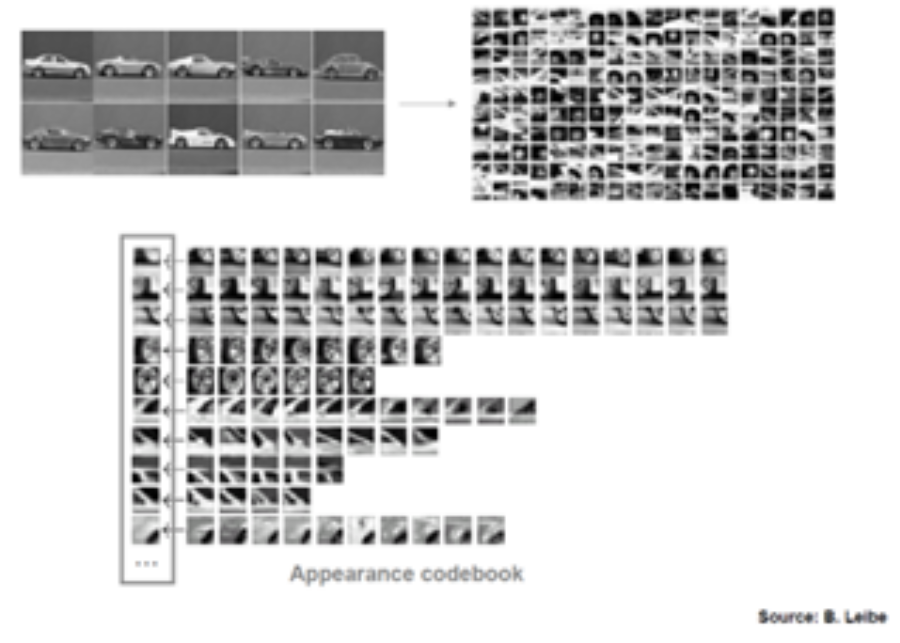
- Đối với dữ liệu hình ảnh, loại bỏ các hình có độ phân giải thấp, bị mờ, bị nhiễu, bị che bởi các vật thể khác…. Điều này sẽ giúp quá trình trích xuất thông tin từ ảnh và học từ đó ra chính xác hơn.
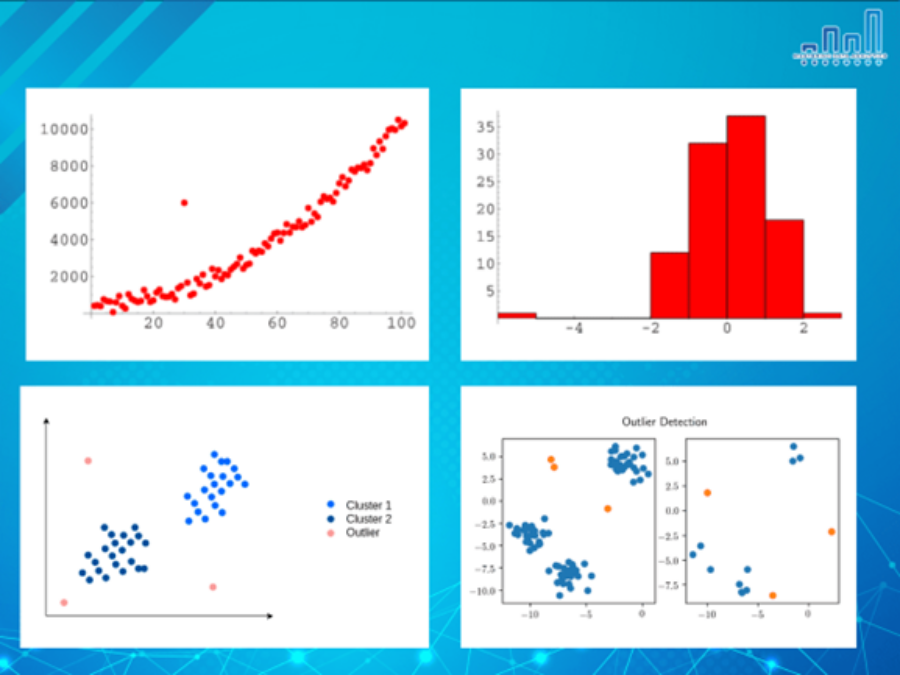
- Lọc dữ liệu ngoại lai: sẽ có những dữ liệu không phù hợp với dữ liệu bạn đang phân tích. Thế nên, trong trường hợp này, xóa giá trị ngoại lai đó sẽ làm tăng chất lượng của dữ liệu của bạn. Có thể lọc trực tiếp trong file csv nếu dễ thấy, ví dụ: trong dự đoán nhà, trung bình input đưa vào là 100-200m2, nếu có dữ liệu nào > 500m2 thì loại ra. Hoặc mình có thể sử dụng biểu đồ visualization, plot bằng Matlab, hoặc dùng Tableau …
Còn nhiều thuật toán, thủ thuật khác để làm sạch dữ liệu cho training AI models.
Tóm lại, 80% thời gian xây dựng một chương trình AI là thu thập và nhất là xử lý dữ liệu. Việc xử lý các đặc trưng của dataset sẽ nâng cao chất lượng của mô hình học tập giúp nâng cao độ chính xác của các chương trình AI. Vì vậy, việc xử lý và làm sạch dữ liệu rất quan trọng trong quá trình xây dựng chương trình AI.
Giảng viên Trần Thị Bảo Hạnh
Bộ môn Công nghệ thông tin
FPT Polytechnic Đà Nẵng