Các chương trình AI đều cần những thuật toán phức tạp, nhiều dữ liệu và các công cụ mạnh để huấn luyện (training), học tập và giải quyết các vấn đề liên quan đến trí tuệ con người. Để chuẩn bị huấn luyện cho AI tạo ra các mô hình (model) sau này, chúng ta thường chuẩn bị số lượng lớn dữ liệu và thường chia làm 2 phần: 80% cho training và 20% cho testing.
Dựa vào kết quả testing có thể biết được hiệu quả, năng suất, độ chính xác của mô hình cũng như chương trình AI đang thiết kế. Vì vậy yêu cầu chất lượng dữ liệu cần chuẩn bị trong quá trình thu thập, xử lý và sử dụng cho AI thường phải đạt tiêu chuẩn tốt và nhất quán.

Thu thập dữ liệu là bước sơ bộ, đầu tiên trong quá trình muốn tạo ra một chương trình AI nào đó. Các tập dữ liệu dành cho các chương trình học máy thiên về phân loại, dự đoán, thị giác máy tính thường nằm ở các dạng: dữ liệu văn bản, dữ liệu hình ảnh, dữ liệu video… Độ lớn của các dữ liệu này thường nhiều và đa dạng, giúp cho các mô hình AI xử lý chi tiết tốt hơn và đưa ra các kết quả tốt hơn.
Thông thường, để đảm bảo việc huấn luyện mô hình hiệu quả, tệp dữ liệu thường lớn, nhưng bao nhiêu là đủ lớn? Có quy tắc thường được sử dụng là bộ dữ liệu nên lớn hơn 10 lần so với các biến (parameter) trong chương trình AI.
Ví dụ: Nếu chương trình của bạn đang cần load 1000 biến số cho thuật toán thì cần ít nhất khoảng 10000 mẫu trong bộ dữ liệu. Vì vậy để tạo một chương trình AI tốt cần rất nhiều data. Chẳng hạn như chương trình phân biệt chó, mèo cơ bản hiện nay cần 25000 bức hình, đang đạt độ chính xác 98%.
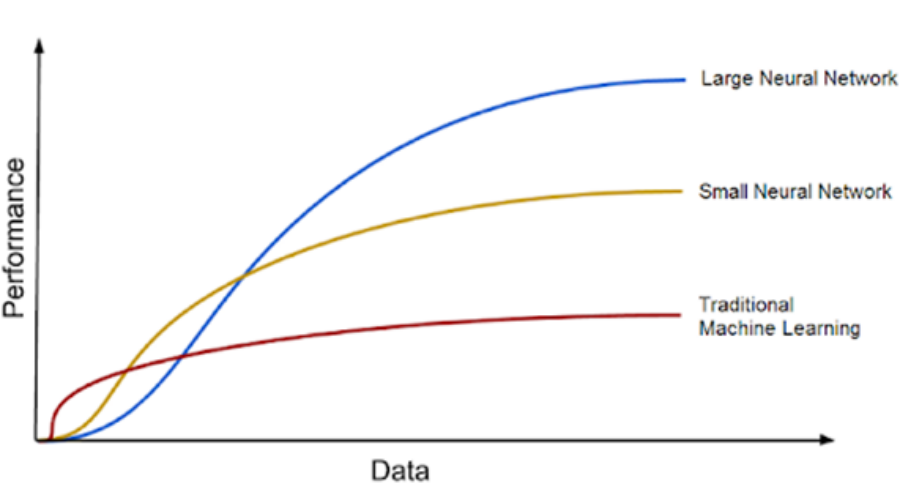
Việc thu thập số lượng từ 10000 mẫu cho đến cả 1000000 mẫu cho một chương trình AI liên quan tới bảo mật như y tế, kinh tế… rất khó khăn vì dính tới bản quyền, luật pháp, sự đồng ý của những người liên quan. Cho nên nếu dữ liệu thu thập không đủ, thậm chí chỉ 100-500, một nửa so với chuẩn thì sẽ như thế nào?
Đối với các trường hợp có quá ít data cần thiết, chúng ta có thể sử dụng một số phương pháp như sau để tăng số lượng mẫu:
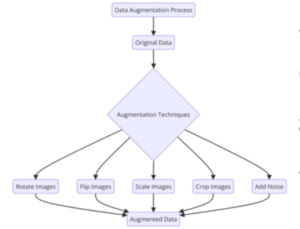
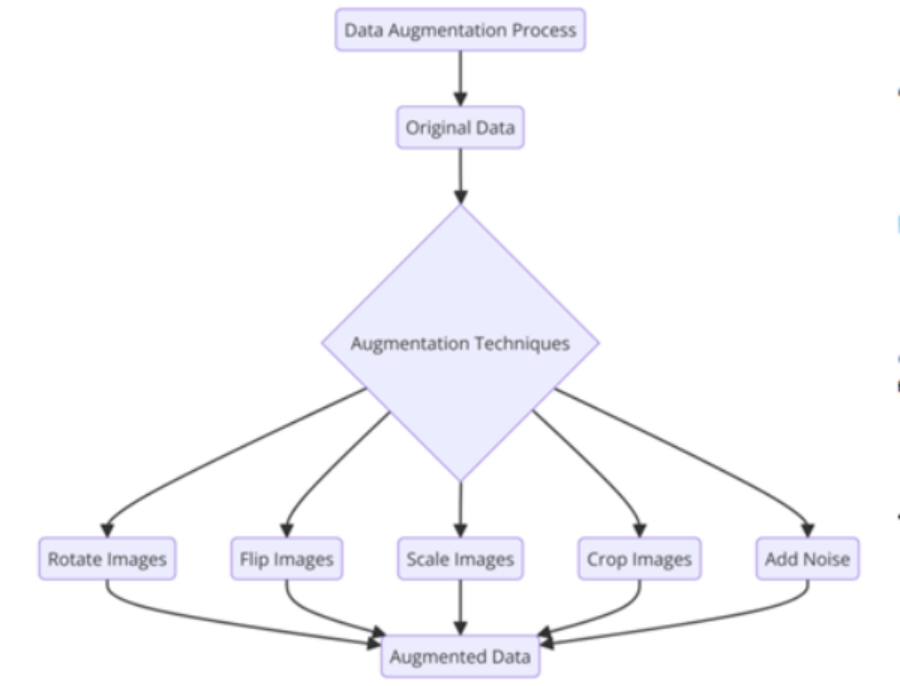
1) Data augmentation ( Tăng cường dữ liệu) : Đây là cách phổ biến thường được sử dụng để tăng dataset lên 1-5 lần so với mẫu cũ. Bằng cách thay đổi dữ liệu một chút so với bản gốc.
Chẳng hạn với 1 hình ảnh của chú chó, chúng ta có thể xoay (rotate), cắt xén ( crop), thu phóng ( zoom in, out), lật ( flip), hay thậm chí tạo thêm một chút nhiễu (noise) để đa dạng hóa các data. Có rất nhiều thư viện (library) hỗ trợ cho các công cụ này dễ dàng. Tuy nhiên cần chú ý quá trình tăng cường, kẻo vật thể bị can thiệp quá nhiều.
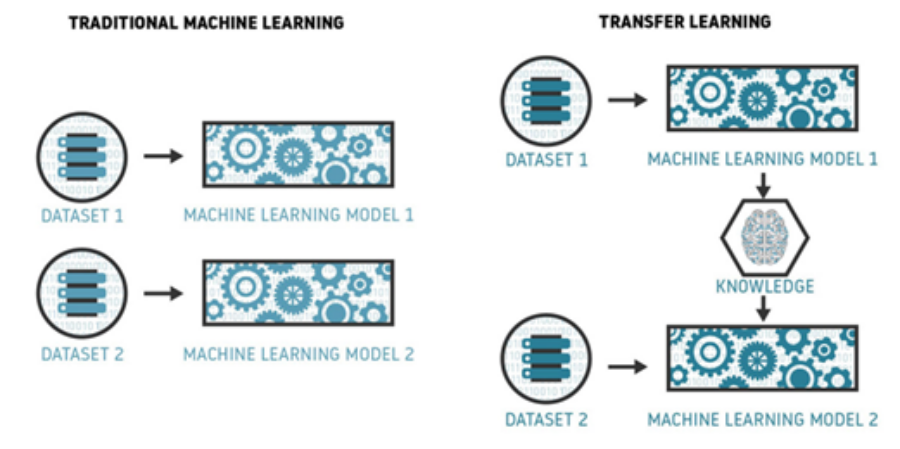
2) Transfer Learning (Học chuyển giao): Đây là một trong các kỹ thuật của học máy sâu ( deep learning) để tăng độ chính xác của chương trình AI cho các dữ liệu có độ bảo mật cao. Chúng ta có thể sử dụng lại, học hỏi từ các mô hình, các neuron của những chương trình chạy trên tệp dữ liệu khác mà cùng mục đích với chúng ta.
Bằng cách sử dụng các frozen layer của các chương trình khác và sử dụng như là các feature extraction các lớp đầu vào của chương trình mình. Phương pháp này cần có các chương trình khác không sẵn sàng share database, nhưng sẵn sàng share model, thuật toán.
Tóm lại, các dataset có ít mẫu sẽ ảnh hưởng nhiều đến kết quả, độ chính xác của mô hình AI. Quá nhiều mẫu ( > 1 triệu mẫu), nếu tăng thì không ảnh hưởng rõ rệt tới hiệu suất của AI. Nhưng nếu quá ít mẫu ( < 1000) thì sẽ ảnh hưởng rất rõ rệt tới chương trình, có thể chỉ <70% accuracy và có thể tăng lên >80% accuracy nếu tăng chất lượng, số lượng dataset.
Cho nên việc thu thập, hỗ trợ tăng dữ liệu là một trong các bước đầu tiên để xây dựng chương trình AI hiệu quả.
Giảng viên Trần Thị Bảo Hạnh
Bộ môn Công nghệ thông tin
FPT Polytechnic Đà Nẵng