Bài viết giúp sinh viên khám phá ứng dụng K-means trong phân tích dữ liệu bệnh nhân. Qua bộ dữ liệu thực tế, sinh viên hiểu rõ thuật toán và áp dụng vào phân loại y tế.

Tổng Quan Về Thuật Toán K-means
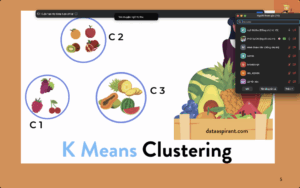
Phân cụm dữ liệu
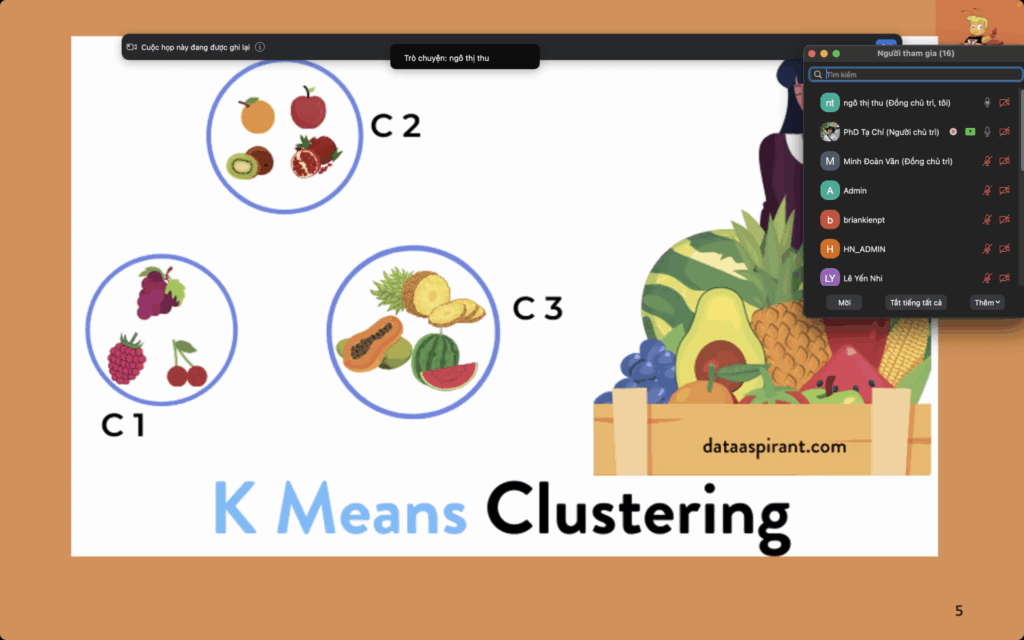
K-means nhóm dữ liệu dựa trên sự tương đồng giữa các điểm.
Các bước chính
Khởi tạo, gán điểm cho cụm, cập nhật trung tâm cụm.
Ưu nhược điểm
Đơn giản, dễ thực hiện nhưng nhạy cảm với khởi tạo và số cụm.
Case Study: Phân Tích Dữ Liệu Bệnh Nhân Tim Mạch
Bài toán
Phân loại bệnh nhân dựa trên nguy cơ tim mạch.
Dữ liệu sử dụng
- Tuổi
- Giới tính
- Huyết áp
- Cholesterol
- Tiền sử bệnh
Mục tiêu
Xác định nhóm bệnh nhân có đặc điểm tương tự.
Số lượng: 300 bệnh nhân.
Tiền Xử Lý Dữ Liệu
Làm sạch dữ liệu
Xử lý giá trị thiếu và loại bỏ nhiễu.
Chuẩn hóa dữ liệu
Đảm bảo thang đo dữ liệu đồng nhất.
Công cụ sử dụng
Python, Pandas, Scikit-learn.
Thực Hiện Thuật Toán K-means
Chọn số cụm
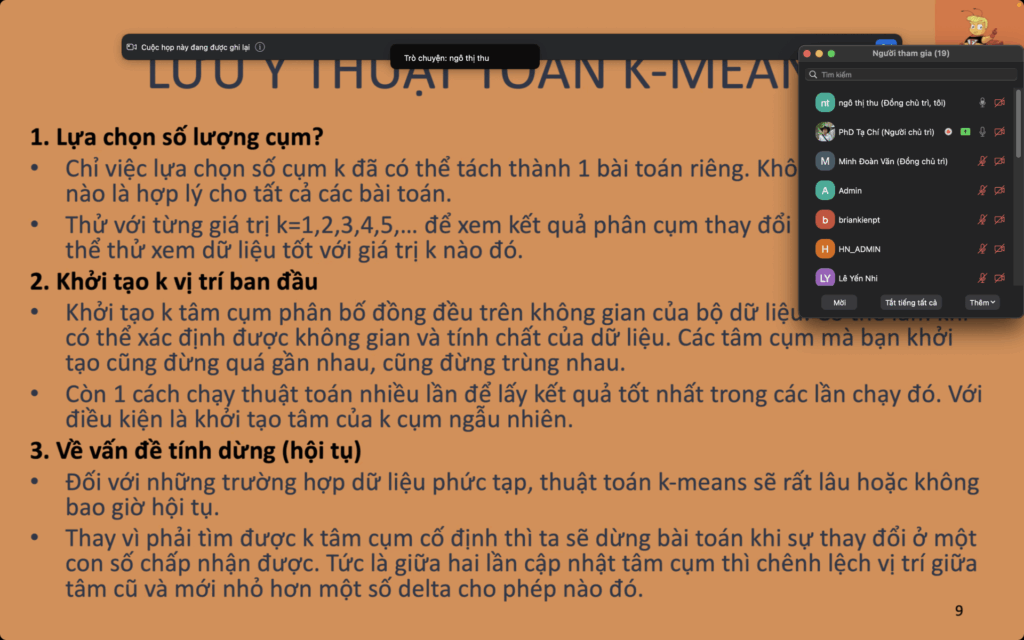
Phương pháp Elbow, Silhouette giúp xác định K.
Khởi tạo trung tâm
Ngẫu nhiên hoặc dùng K-means++ để cải thiện hiệu quả.
Lặp cập nhật
Gán điểm, cập nhật trung tâm cho đến hội tụ.
Đánh giá
Sử dụng Silhouette score và Davies-Bouldin index.
Đánh Giá và Phân Tích Kết Quả
Trực quan hóa
Dùng biểu đồ phân tán thể hiện cụm.
Phân tích đặc điểm
Khai thác sự khác biệt giữa nhóm bệnh nhân.
Ý nghĩa lâm sàng
Xác định yếu tố nguy cơ chính từng nhóm.
Công cụ
Matplotlib và Seaborn.
Thảo Luận và Ứng Dụng Thực Tế
Thảo luận kết quả
So sánh với nghiên cứu trước đó về phân cụm bệnh nhân.
Ứng dụng thực tế
Dự đoán nguy cơ, cá nhân hóa điều trị bệnh nhân.
Tiềm năng phát triển
Kết hợp thuật toán khác, áp dụng trên dữ liệu lớn.
Kết Luận
Tóm tắt
Các bước thực hiện và kết quả đạt được trong dự án.
Vai trò K-means
Quan trọng trong phân tích dữ liệu y tế đa chiều.
Khuyến khích
Tiếp tục nghiên cứu và áp dụng trong các dự án thực tế.
Hỏi đáp
Giải đáp thắc mắc và trao đổi chuyên sâu.
Giảng viên Nguyễn Thanh Nam
Bộ môn Ứng dụng phần mềm
FPT Polytechnic Hà Nội